Anthropic روز سهشنبه، Claude Fable 5.1 و Claude Mythos 5.1 را منتشر کرد، که این اولین بهروزرسانی خط مدلهای کلاس Mythos این شرکت از زمان عرضه Fable 5 در ۹ ژوئن است.
این شرکت ادعا میکند که مدلهای هوش مصنوعی جدیدش «پیشرفتهترین مدلهای جهان برای برنامهنویسی و کارهای دانشی» هستند و این عرضه سه ماه پس از یک چرخه راهاندازی صورت میگیرد که پیش از این شامل توقف ۱۸ روزه کنترل صادرات، درگیری قیمتی در میانه تابستان بر سر دسترسی به اشتراک، و عرضه Claude Opus 5 در ماه جولای بود که قیمت Fable 5 را کاهش داده بود.
Fable 5.1 و Mythos 5.1، طبق گفته Anthropic، یک مدل زیربنایی با فیلترهای امنیتی متفاوت هستند. Fable 5.1 به طور عمومی برای هر کسی که حساب Claude دارد در دسترس است. Mythos 5.1 همچنان به متخصصان تأیید شده امنیت سایبری و علوم زیستی از طریق برنامه تأیید سایبری Anthropic و برنامه تأیید علوم زیستی، که جانشین مسیر دسترسی Project Glasswing است که دسترسی به Mythos 5 را محدود میکرد، محدود میماند.
معیارها واقعاً چه چیزی را اندازه میگیرند
عدد اصلی Anthropic از Terminal-Bench-Science 0.1 میآید، معیاری که آزمایش میکند آیا یک عامل هوش مصنوعی میتواند وظایف تحقیقات علمی را در محیط خط فرمان انجام دهد، که به صورت نرخ قبولی امتیازدهی میشود.
Fable 5.1 به امتیاز ۵۲.۶٪ دست یافت، در مقایسه با ۲۴.۷٪ Fable 5 و ۲۹.۰٪ Opus 5، که بیش از دو برابر مدل قبلی خود است.
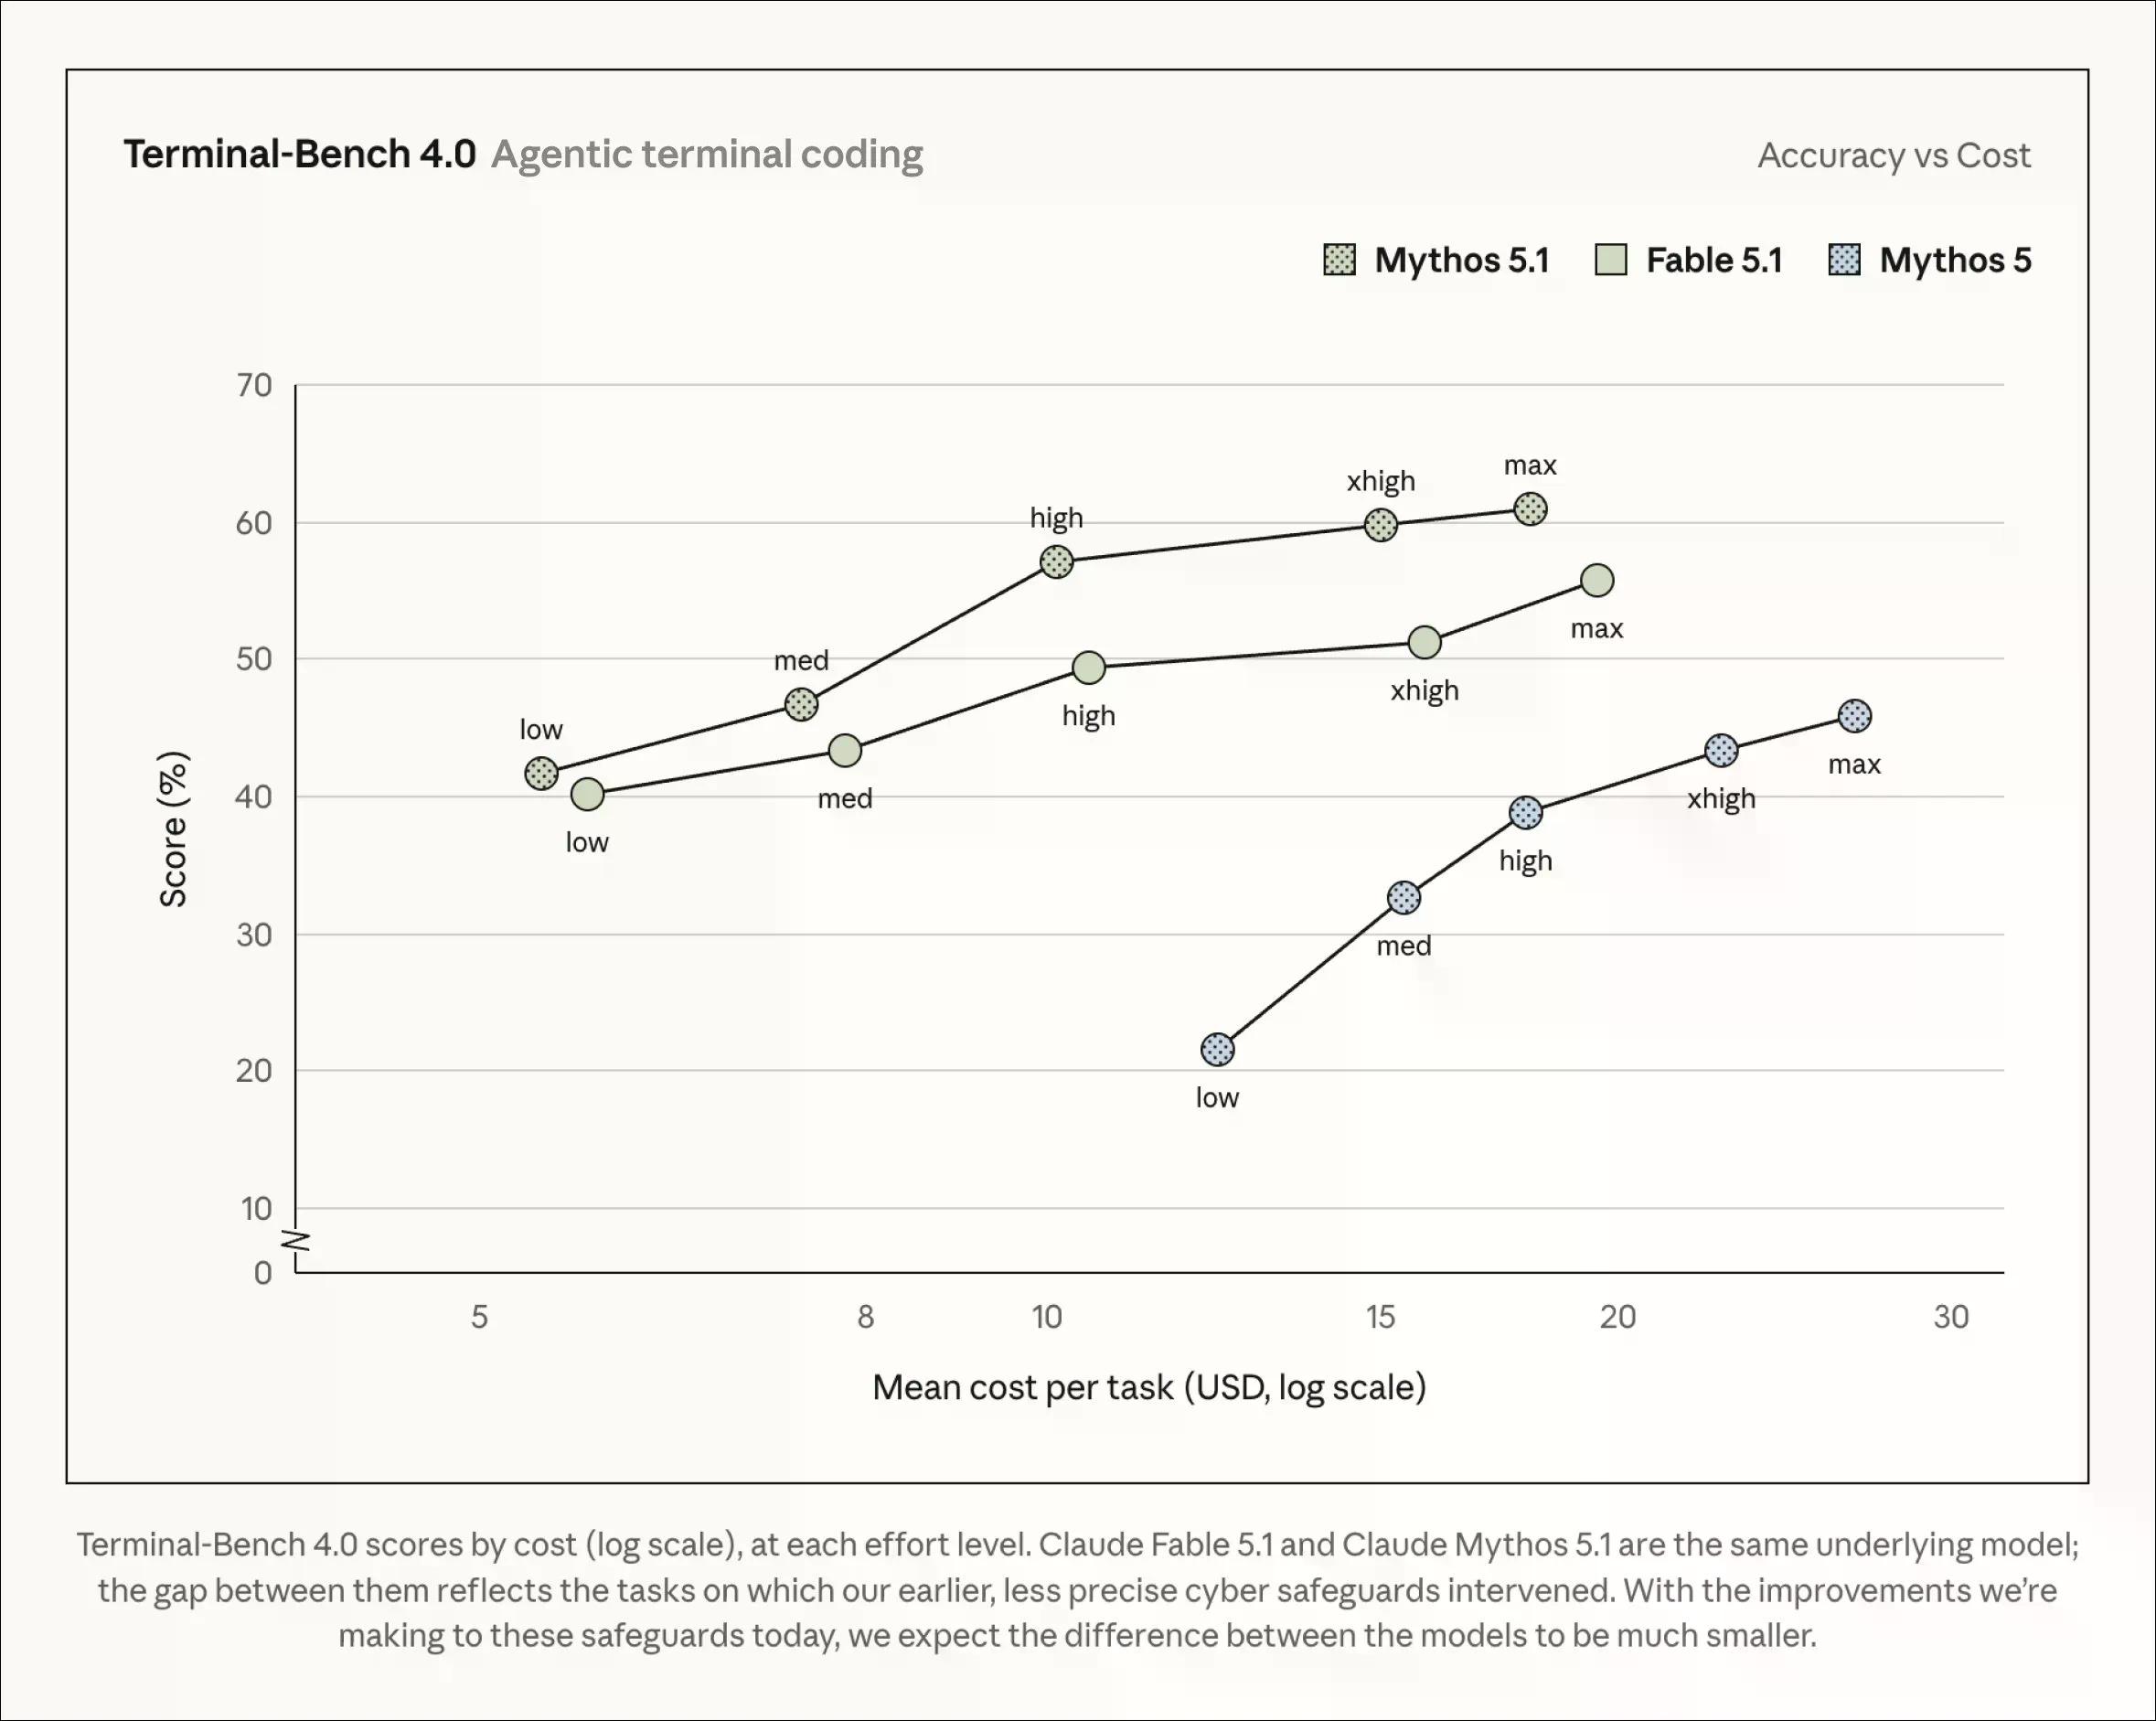
Terminal-Bench 4.0 برنامهنویسی عاملمحور را که از طریق ترمینال انجام میشود – نوشتن، اجرا، و اشکالزدایی کد در جلسات چند مرحلهای خط فرمان – آزمایش میکند که به صورت درصدی از وظایف صحیح تکمیل شده امتیازدهی میشود. Fable 5.1 امتیاز ۵۵.۸٪ را کسب کرد، که از ۴۲.۰٪ Fable 5 بیشتر و از ۵۲.۳٪ Opus 5 جلوتر است.
Mythos 5.1، که با فیلترهای امنیت سایبری سبکتر اجرا میشود، در همین آزمایش ۶۰.۹٪ امتیاز گرفت؛ Anthropic میگوید این اختلاف نشاندهنده وظایفی است که مکانیزمهای حفاظتی آن رهگیری کرده و به Opus 4.8 هدایت مجدد کردهاند.
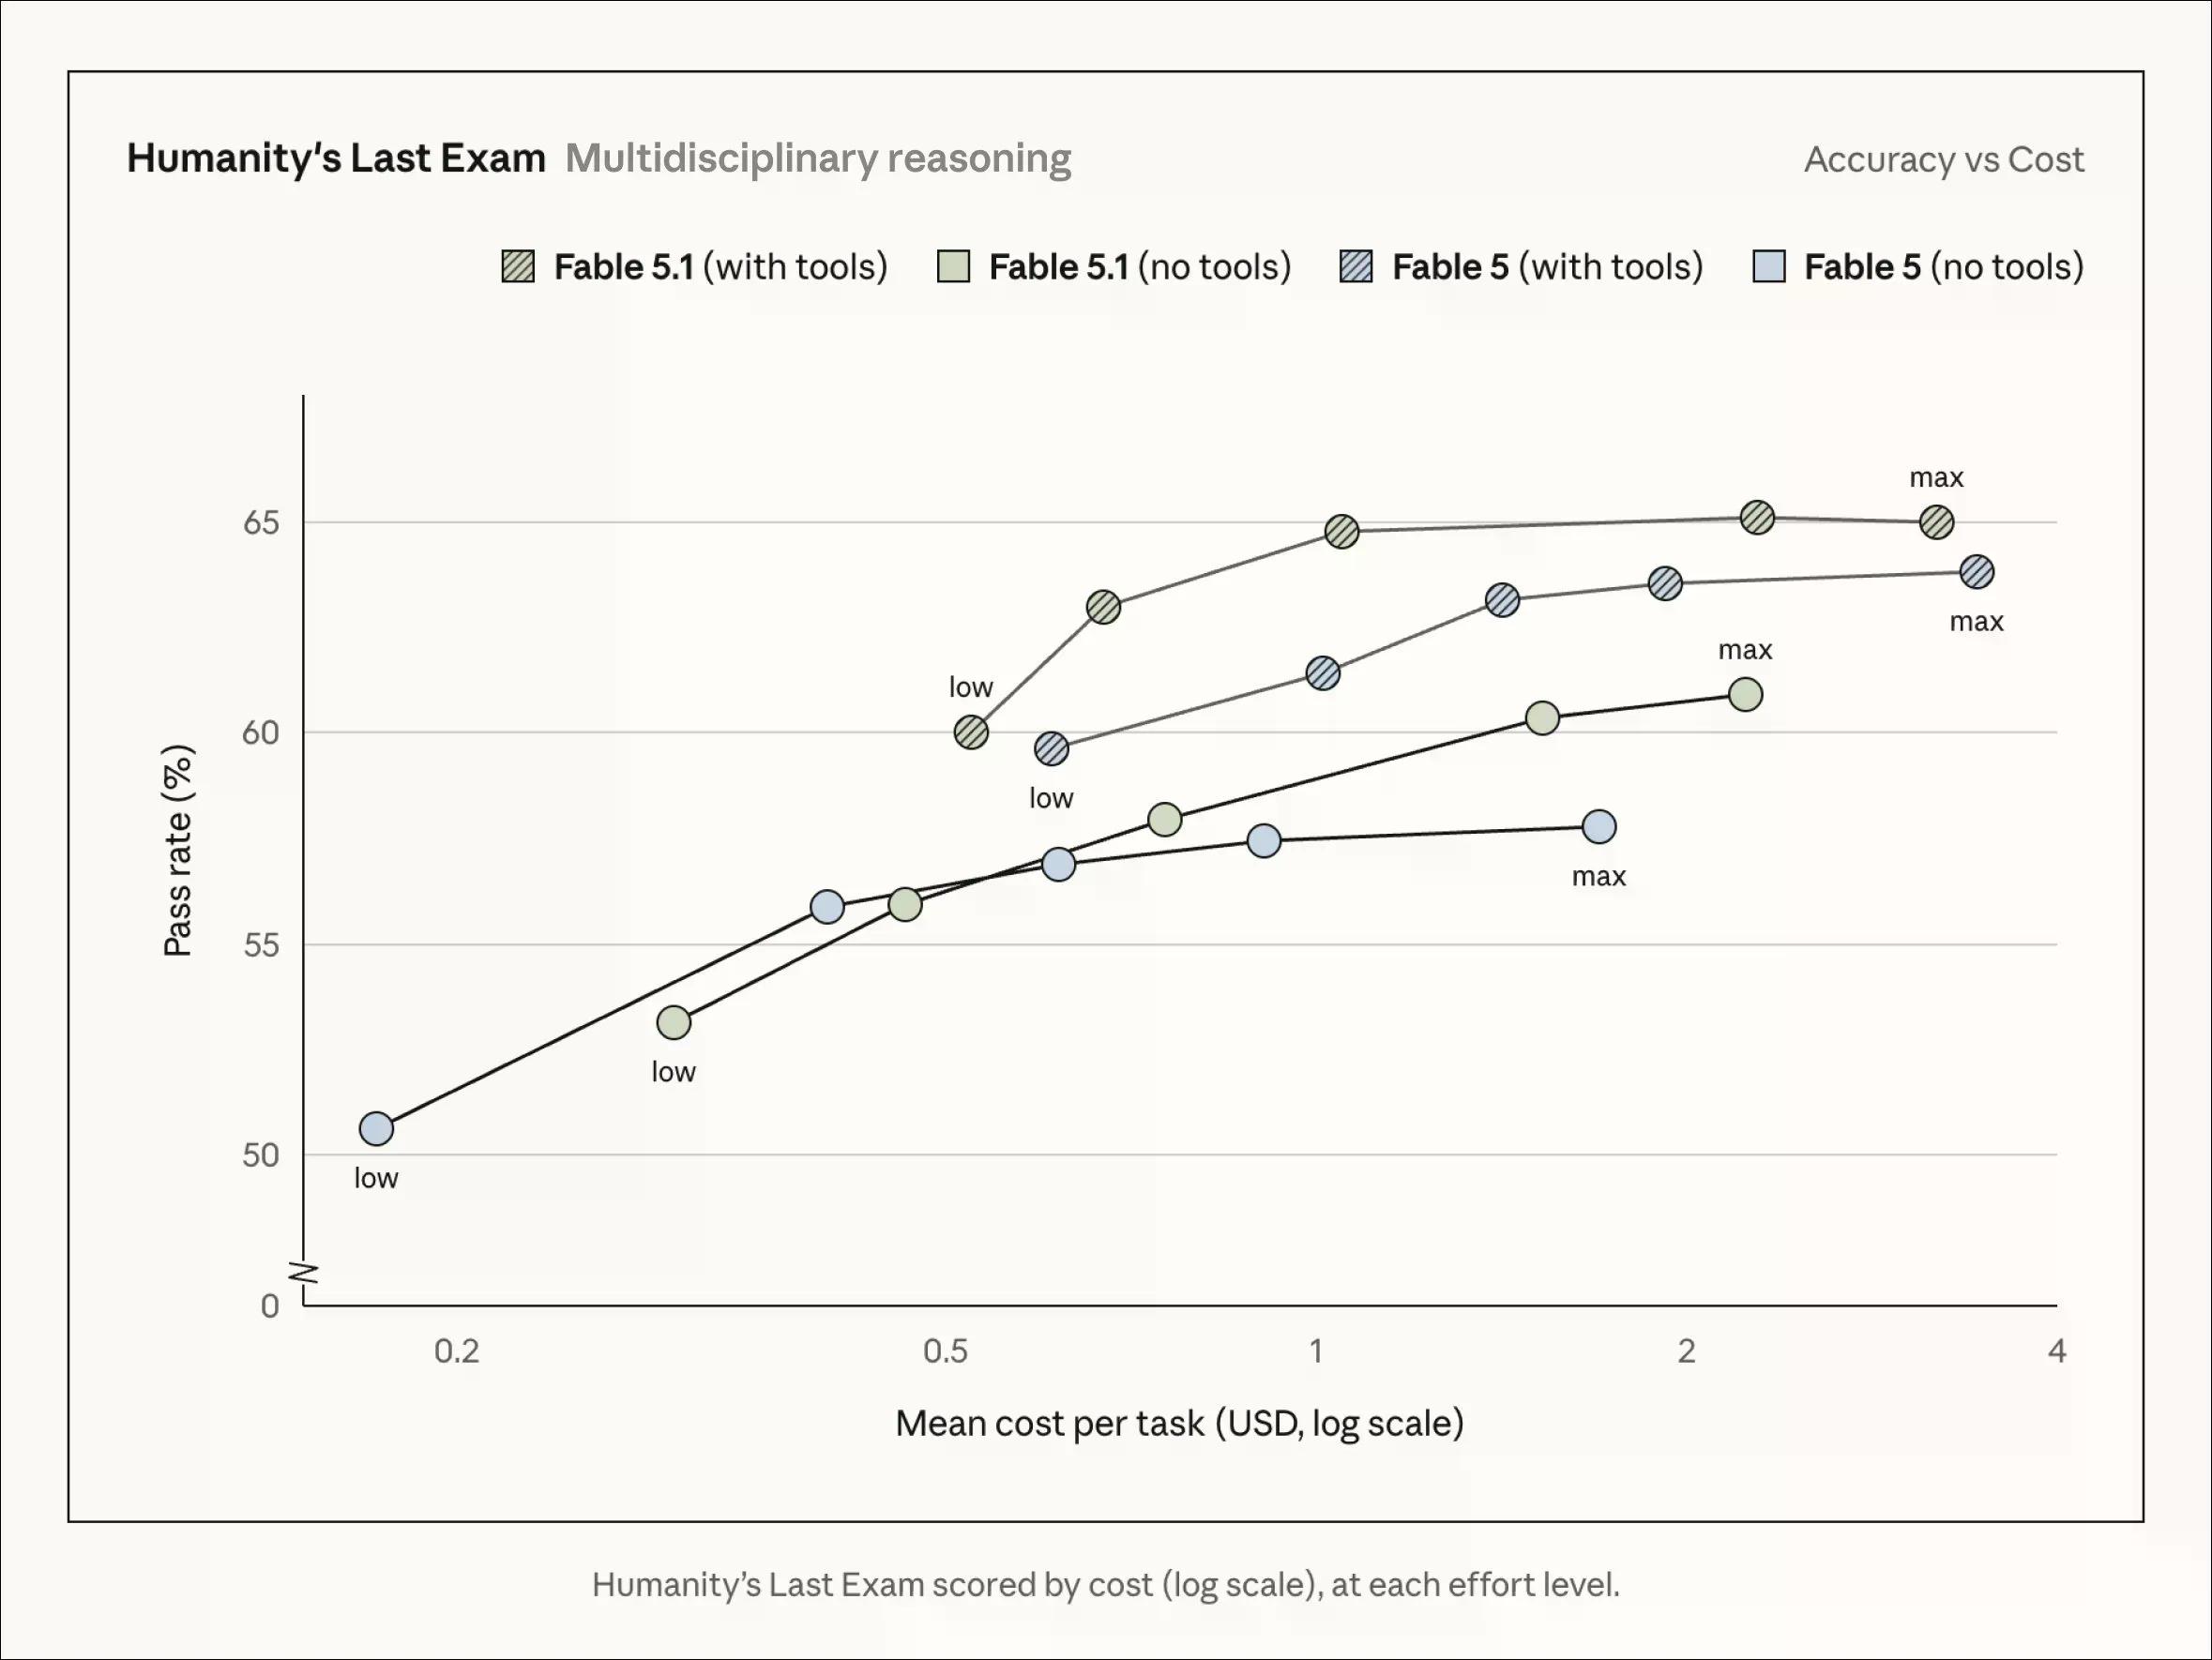
در آزمون نهایی بشریت (Humanity's Last Exam)، که یک آزمون استدلال چندرشتهای است و از سؤالات در سطح کارشناسی از دهها رشته دانشگاهی تشکیل شده و به صورت نرخ قبولی امتیازدهی میشود، Fable 5.1 بدون ابزارهای خارجی به امتیاز ۶۰.۹٪ و با آنها به ۶۵.۰٪ رسید که هر دو از Opus 5 جلوتر هستند و نشان میدهد که این پیشرفتهترین مدل Anthropic برای اهداف دانشگاهی است.
جایی که Opus 5 را شکست میدهد، و جایی که محاسبات پیچیدهتر میشوند
Opus 5 در ماه جولای با نیمی از قیمت هر توکن Fable 5 عرضه شد، در حالی که در اکثر معیارهای اصلی از Fable 5 امتیاز بیشتری کسب کرد و عملاً مدل پرچمدار را برای اکثر کاربران پرداختکننده زائد کرد.
Fable 5.1 این وضعیت را معکوس میکند: اکنون در هر معیار منتشر شده توسط Anthropic، از جمله مواردی که Opus 5 قبلاً Fable 5 را شکست داده بود، از Opus 5 پیشی میگیرد.
اما Fable 5.1 همچنان دو برابر Opus 5 به ازای هر توکن هزینه دارد – ۱۰ دلار ورودی و ۵۰ دلار خروجی در مقایسه با ۵ دلار و ۲۵ دلار Opus 5. توکنها مقدار اساسی اطلاعاتی هستند که یک مدل میتواند مدیریت کند (معمولاً حدود دو سوم یک کلمه انگلیسی متوسط)، و شرکتها برای استفاده هزینه میپردازند زیرا حجم کاری سنگین معمولاً سهمیههای تعیین شده در طرحهای اشتراک را به سرعت مصرف میکند.
معرفی Anthropic برای این مدل بر سطوح تلاش تکیه دارد تا نمرات خام: این شرکت میگوید اجرای Fable 5.1 با تلاش استدلال کم یا متوسط، با نتایج قدیمی Fable 5 با هزینه بسیار کمتر مطابقت دارد یا از آن پیشی میگیرد، در حالی که سطوح بالاتر تلاش را برای مشکلاتی که سایر مدلها را گیج میکنند، نگه میدارد.
برای کارهای روزمره، این استدلال برای صرفنظر کامل از Opus 5 هرچه میزان تلاش کمتر شود، ضعیفتر میشود.
دسترسی نیز از همان رویکردی پیروی میکند که پس از ماهها تنظیم شرایط توسط Anthropic برای Fable 5 اعمال شد. در طرحهای حرفهای و حسابهای استاندارد تیمی یا سازمانی، Fable 5.1 به طور کامل از اعتبارات استفاده پرداخت در ازای مصرف که با نرخ API محاسبه میشوند، استفاده میکند، زیرا بخشی از محدودیتهای هفتگی این طرحها نیست. در طرحهای مکس و حسابهای تیمی یا سازمانی پریمیوم، به عنوان بخشی استاندارد از اشتراک، تا ۵۰٪ از مصرف هفتگی را پوشش میدهد.
Claude Fable 5.1 اکنون در Claude API، Amazon Bedrock، Google Cloud و Microsoft Foundry، تحت شناسه مدل "claude-fable-5-1" در دسترس است.