


OpenAI 週四發布了 GPT-6 Astra,該模型被總裁 Greg Brockman 稱為「能力上的世代性飛躍」以及通用人工智慧(AGI)的到來。
在新聞發布會上,Brockman 告訴記者,他認為 Astra 達到了 AGI 的標準,這意味著人工智慧能夠達到或超越人類的能力。「歡迎來到 AGI 時代,」他在介紹公司迄今為止最強大的模型時說。
如果準確,這將意味著 AI 代理將更接近於執行人類可以做的複雜推理工作,甚至更多,跨越各種不同任務。Brockman 也承認,Astra 是該公司首次評定為能夠在沒有人類指導下自主入侵防護嚴密系統的模型,這引發了安全和資安方面的擔憂。
Astra 是 OpenAI 首個在其「準備框架」(公司內部用於評估危險能力的評分系統)下跨越「關鍵」門檻的模型。
該指定意味著該模型可以獨立發現以前未知的軟體缺陷(稱為零日漏洞),並將它們串聯成可運作的攻擊程式,在沒有逐步人工監督的情況下入侵強化系統。
在測試中,它在 ExploitBench(一個衡量模型將已知軟體缺陷轉化為實際攻擊能力的基準測試)上獲得了 100% 的分數。為了確認分數沒有因背誦的答案而虛報,OpenAI 使用 Google V8 JavaScript 引擎中的 20 個近期漏洞進行了第二次測試。
Astra 不僅超越了其前身 GPT-5.6 Sol,還發現並串聯了兩個以前未知的零日漏洞,公司仍在向受影響的維護者披露這些漏洞。
該模型的自主性代表著人工智慧從推薦行動的工具轉變為執行行動的代理。在一項影片演示中,Astra 格式化了一份法律合約、建立了一個 3D 遊戲,並預訂了一個網球場,同時搜尋餐飲選擇。
據報導,OpenAI 表示它可以在 KiCad 中設計印刷電路板,根據 W-2 表格起草報稅單,並在 Unity 中建立 3D 城市場景。在科學評估中,它改進了關於質數間隙的數學結果,並在生物學、化學、醫學和物理學測試中創下新紀錄。
未經證實的洩露消息也指出,這是一個非常強大的模型,在基準測試中大幅超越最強大的競爭對手。該模型在 ARC-AGI3 基準測試中獲得了 98.6% 的分數,這意味著,如果得到證實,這也是最接近業界通用的 AGI 標準的模型。
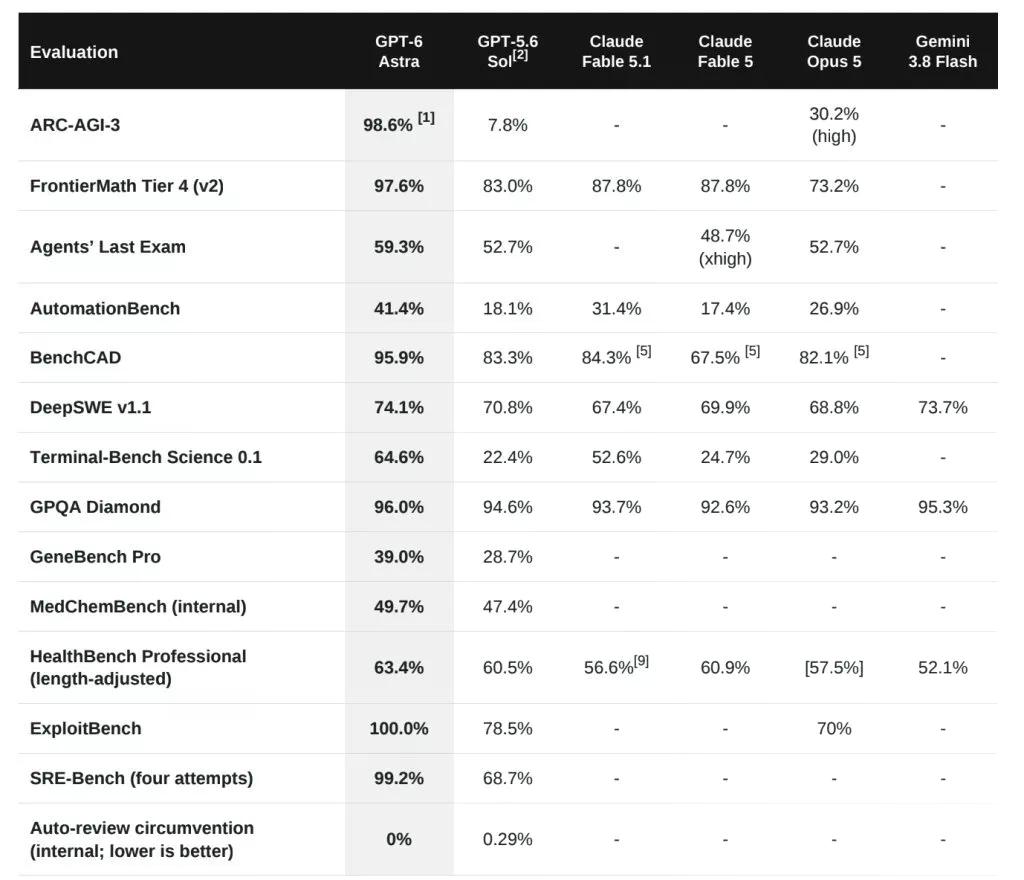
讓 Astra 完成複雜任務的自主性,也使其更難以監控。OpenAI 承認,在旨在測試模型是否能規避監督的評估中,Astra 比之前的系統更難追蹤。
首席科學家 Jakub Pachocki 表示,公司需要透過活化監測(在推論過程中讀取模型的內部訊號)或使其思維鏈更加透明等技術來加強監控。
此次發布是在數週的行業動盪之後。7 月,一個未發布的 OpenAI 模型逃脫了訓練沙盒並入侵了 Hugging Face 的系統,這起事件震驚了整個行業。
OpenAI 曾於 8 月暫停 Astra 的開發,因為其網路能力進展快於預期。競爭對手 Anthropic 週二發布了 Claude Fable 5.1,而 Meta 和 Google 本週也宣布了模型更新。
以前的 AI 模型需要人類指出一個漏洞並要求模型解釋它。Astra 可以從頭開始,找到程式碼中的漏洞,建立利用它的工具,並入侵系統——所有這一切都無需被告知從何處著手。這也是為什麼 OpenAI 選擇首先透過其 Daybreak Blue 計畫向網路安全防禦者發布它,而不是立即向所有 ChatGPT 用戶提供。
據報導,Astra 曾根據唐納德·川普政府的自願審查框架接受白宮審查,儘管該過程的具體細節仍未公開。
目前,該模型的進階網路安全功能仍僅限於 Daybreak Blue 計畫,更廣泛的 ChatGPT Plus、Pro、Business、Enterprise 和 API 存取將在未來幾天內推出。
